

Система оцифровки печатных СМИ и электронный архив на OCR
РБК нужна была система оцифровки печатных документов, чтобы быстрее собирать огромный электронный архив изданий, выходящих в России. Мы взяли на себя бэкенд, фронтенд и дизайн.
- Медиа
- Разработка
- Дизайн
- Аналитика
- 2019–2021

- Бэкенд, фронтенд и дизайн — на стороне CRT
- Работали с 2019 по 2021 год
Главное о проекте
На старте работ для оптического распознавания символов широко использовалась только программа FineReader. Её функций не хватало, и она не соответствовала масштабу проекта, поэтому команда начала искать более подходящие технологические решения.
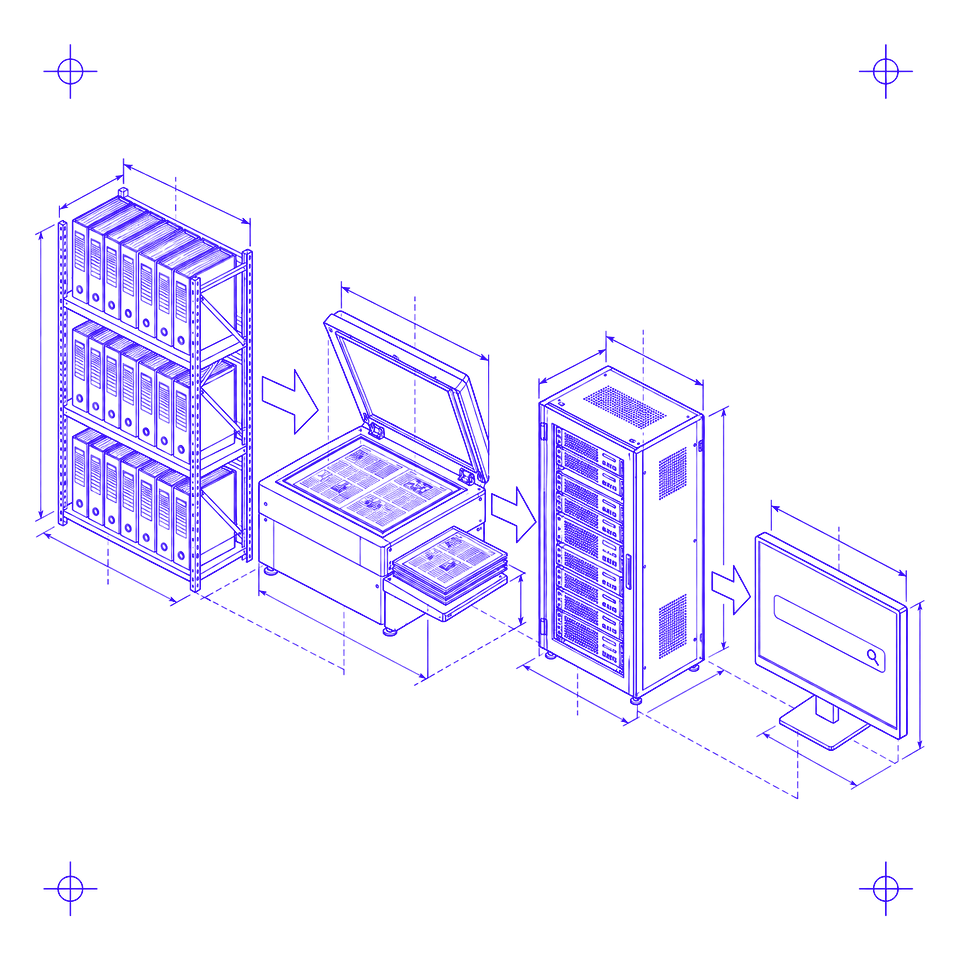
Мы провели большую аналитическую работу: ездили к клиенту, разобрались, как формируется электронный архив, и написали схему, как это должно работать быстро и без проблем.
задача
Упростить и ускорить формирование гигантского электронного архива печатных изданий РФ. Популярный тогда FineReader не давал нужных функций для проекта такого масштаба.
Что сделали
- Аналитика на месте — изучили процессы клиента и описали схему быстрой работы архива
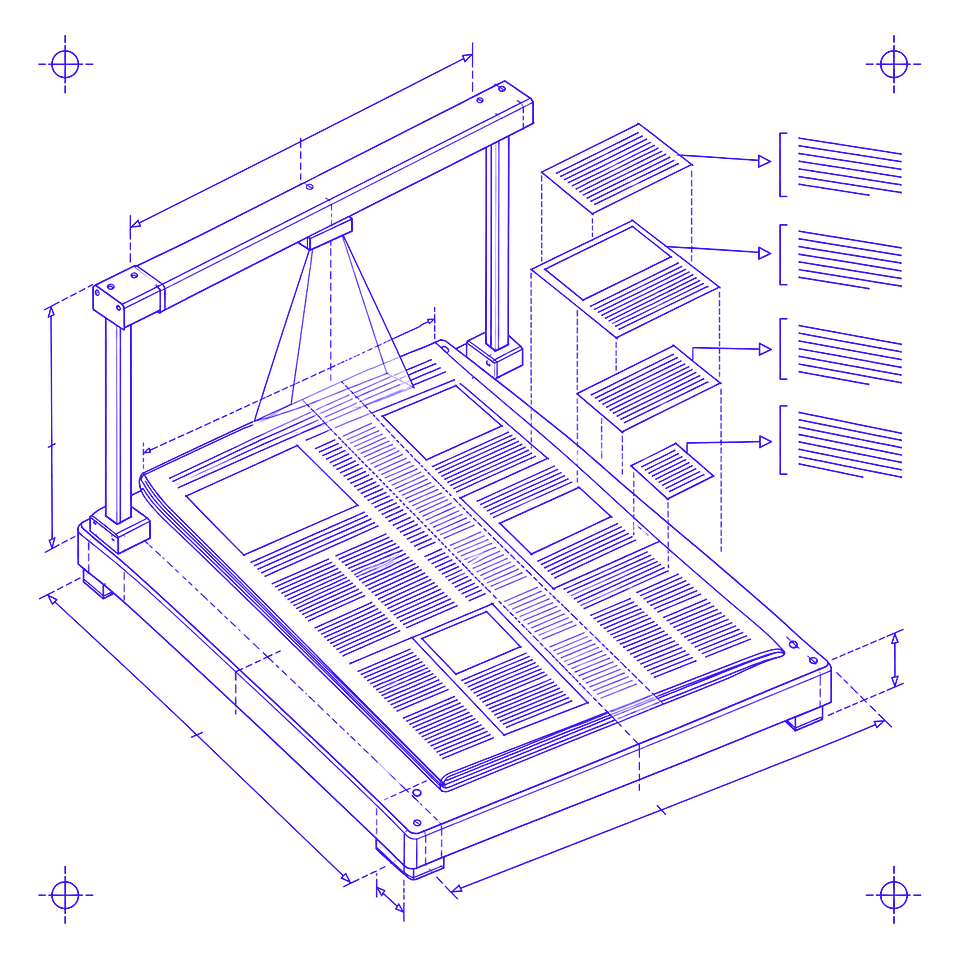
- Загрузка и распознавание — сканы автоматически попадают в общую базу в порядке выхода изданий. За основу взяли OCR Tesseract и доработали распознавание под требования проекта: сервис делит страницу на статьи, абзацы и заголовки и помнит координаты каждого блока
- Поиск — по всему архиву по одному слову, для нераспознанных слов — словари замен
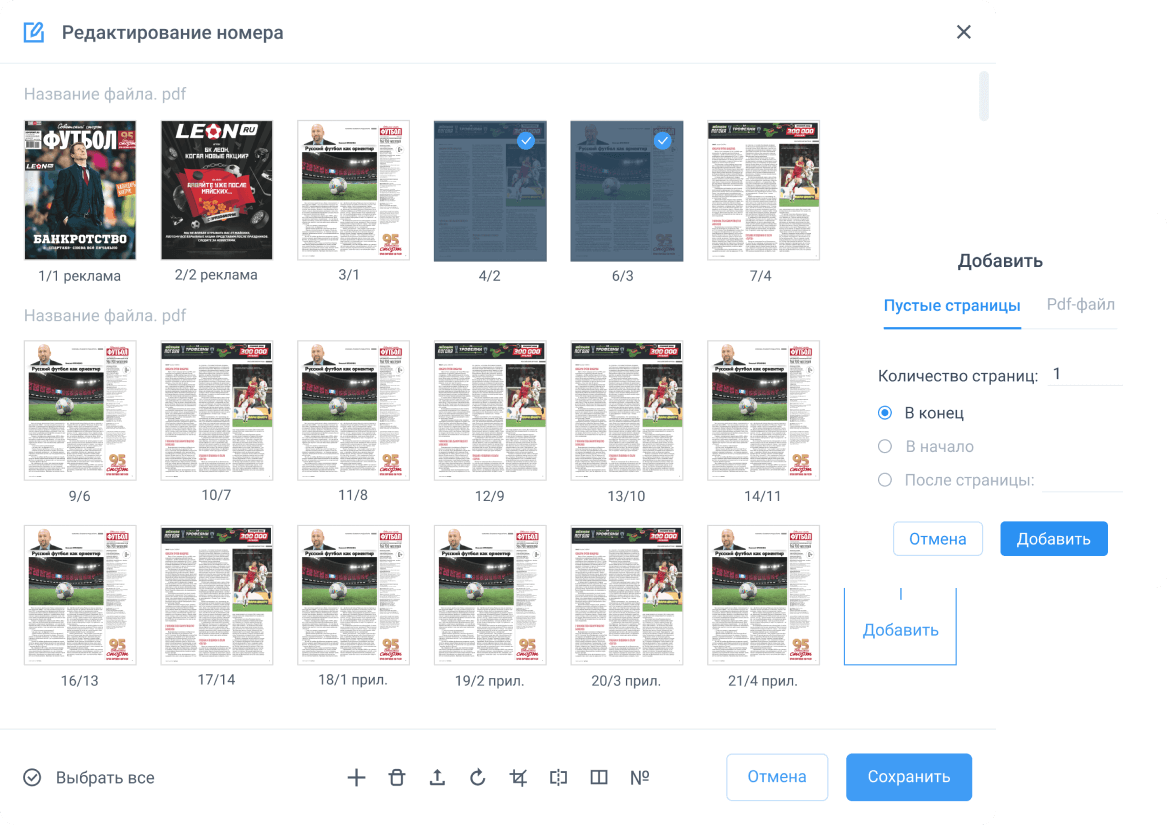
- Админка для разметки блоков — с горячими клавишами и WYSIWYG-редактором
подробности
Технология OCR
За основу взяли технологию оптического распознавания символов (OCR) и доработали её под требования проекта. Это позволило сделать много удобных функций, которые в то время стали настоящим ноу-хау.
- Все отсканированные документы автоматически попадали в общую базу файлов
- Файлы шли в порядке выхода изданий, и все архивы собирались в правильной последовательности
- Поиск по релевантным запросам: достаточно ввести одно слово, и оператор найдёт нужное упоминание во всём архиве изданий
- С нуля создали «Каталог эмитентов» и раздел управления каталогом в ACMS
- Для работы с нераспознанными словами добавили словари замен
- Отдельной большой задачей стала разработка интерфейса административной панели с поддержкой горячих клавиш
подробности
Как работает сервис
- На экране пользователь видит исходный документ — фото или скан печатной страницы газеты или журнала, на котором автоматически размечены области с текстом
- Блоки, извлечённые из исходного документа, «помнят» координаты: из какого абзаца и какой страницы исходника они взяты. По клику можно вернуться к оригиналу и проверить точность расшифровки
- Сервис определяет, что на одной странице расположено несколько статей, и сам разбивает их на отдельные документы с абзацами и заголовками
- Если части публикации разбросаны по странице хаотично, оператор в WYSIWYG-редакторе быстро размечает порядок блоков для обработки и получает аккуратный связный текст
команда
Комментарии команды
Мы создали систему, которая работает максимально быстро и требует минимум действий от оператора. Полагаю, у нас получился продукт, который мог бы быть полезен для многих компаний на стыке печатных и цифровых медийных отраслей. Полученный опыт позволит быстро адаптировать наработки под задачу конкретного клиента.
 ЕвгенийФронтенд-разработчик
суть проекта
Проект в цифрах и схемах
157 тыс.тысяч страниц архива перенесли в онлайн, одна клетка — тысяча страниц
проект
Как это выглядит
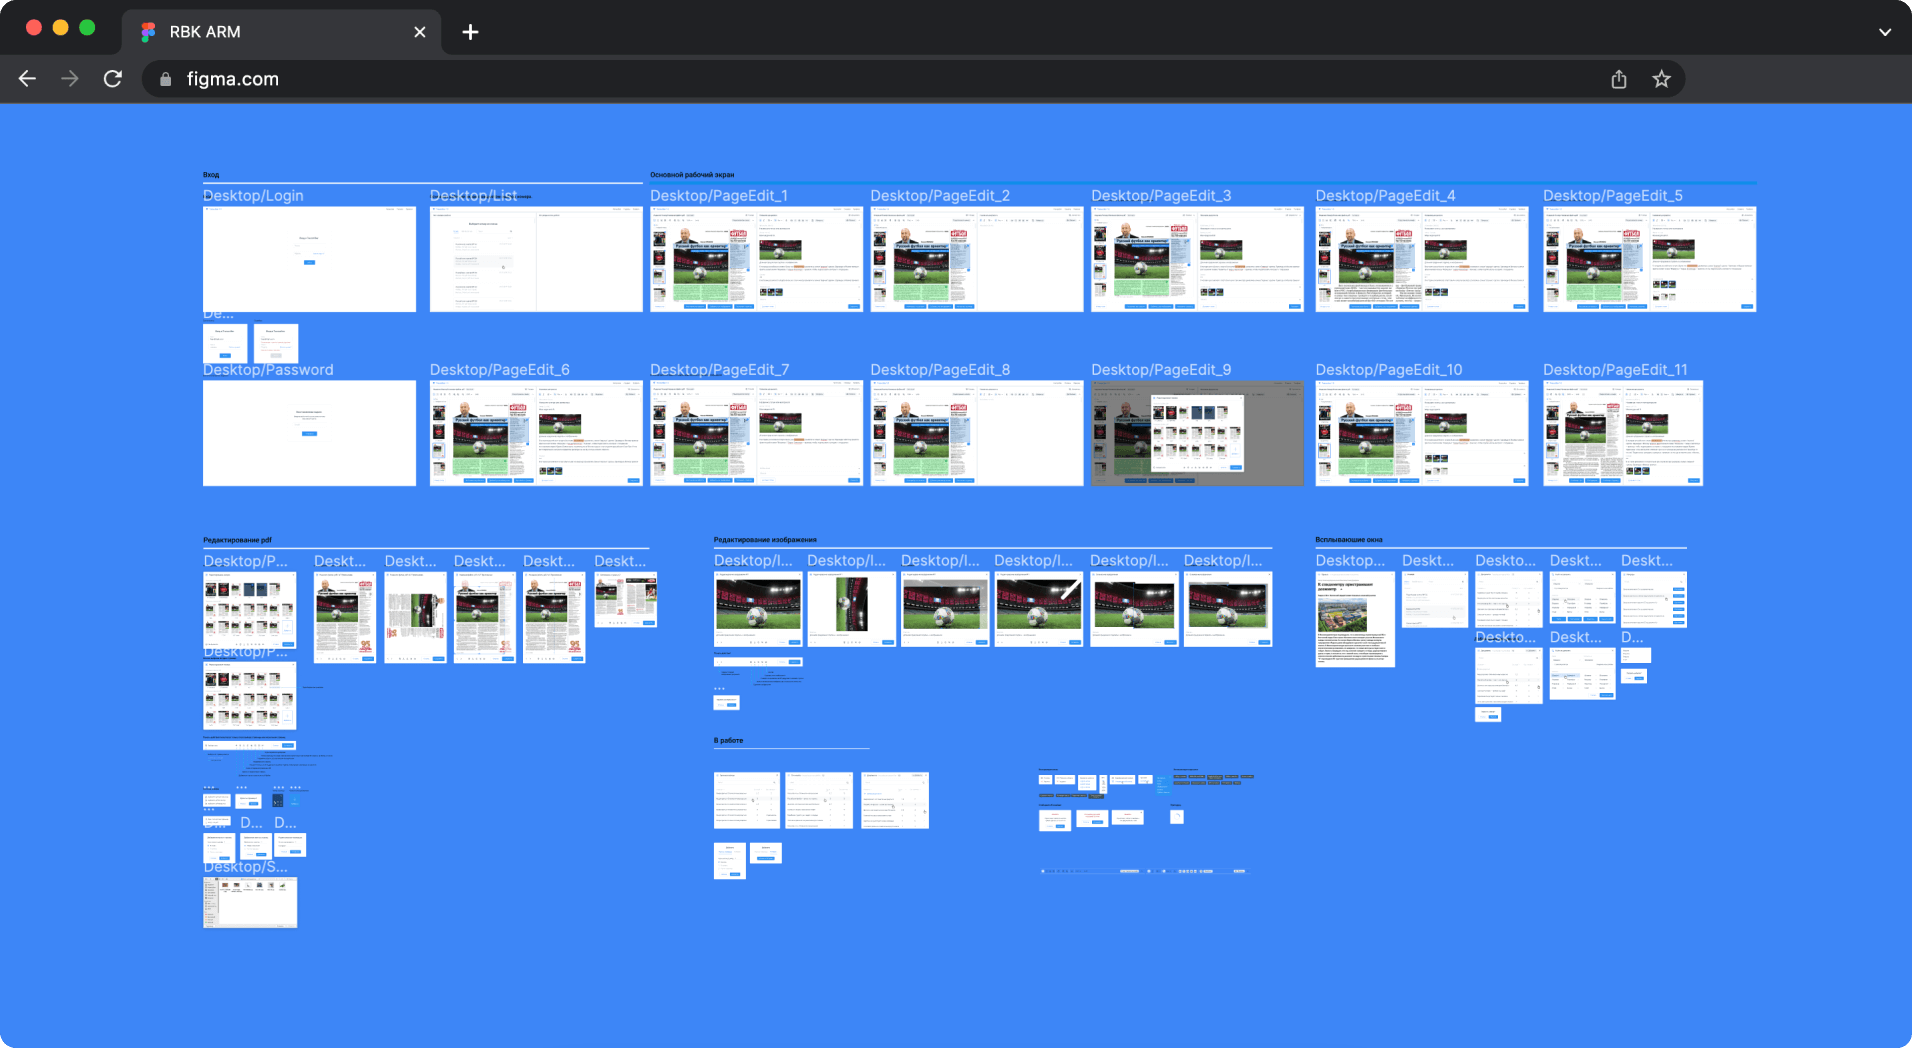
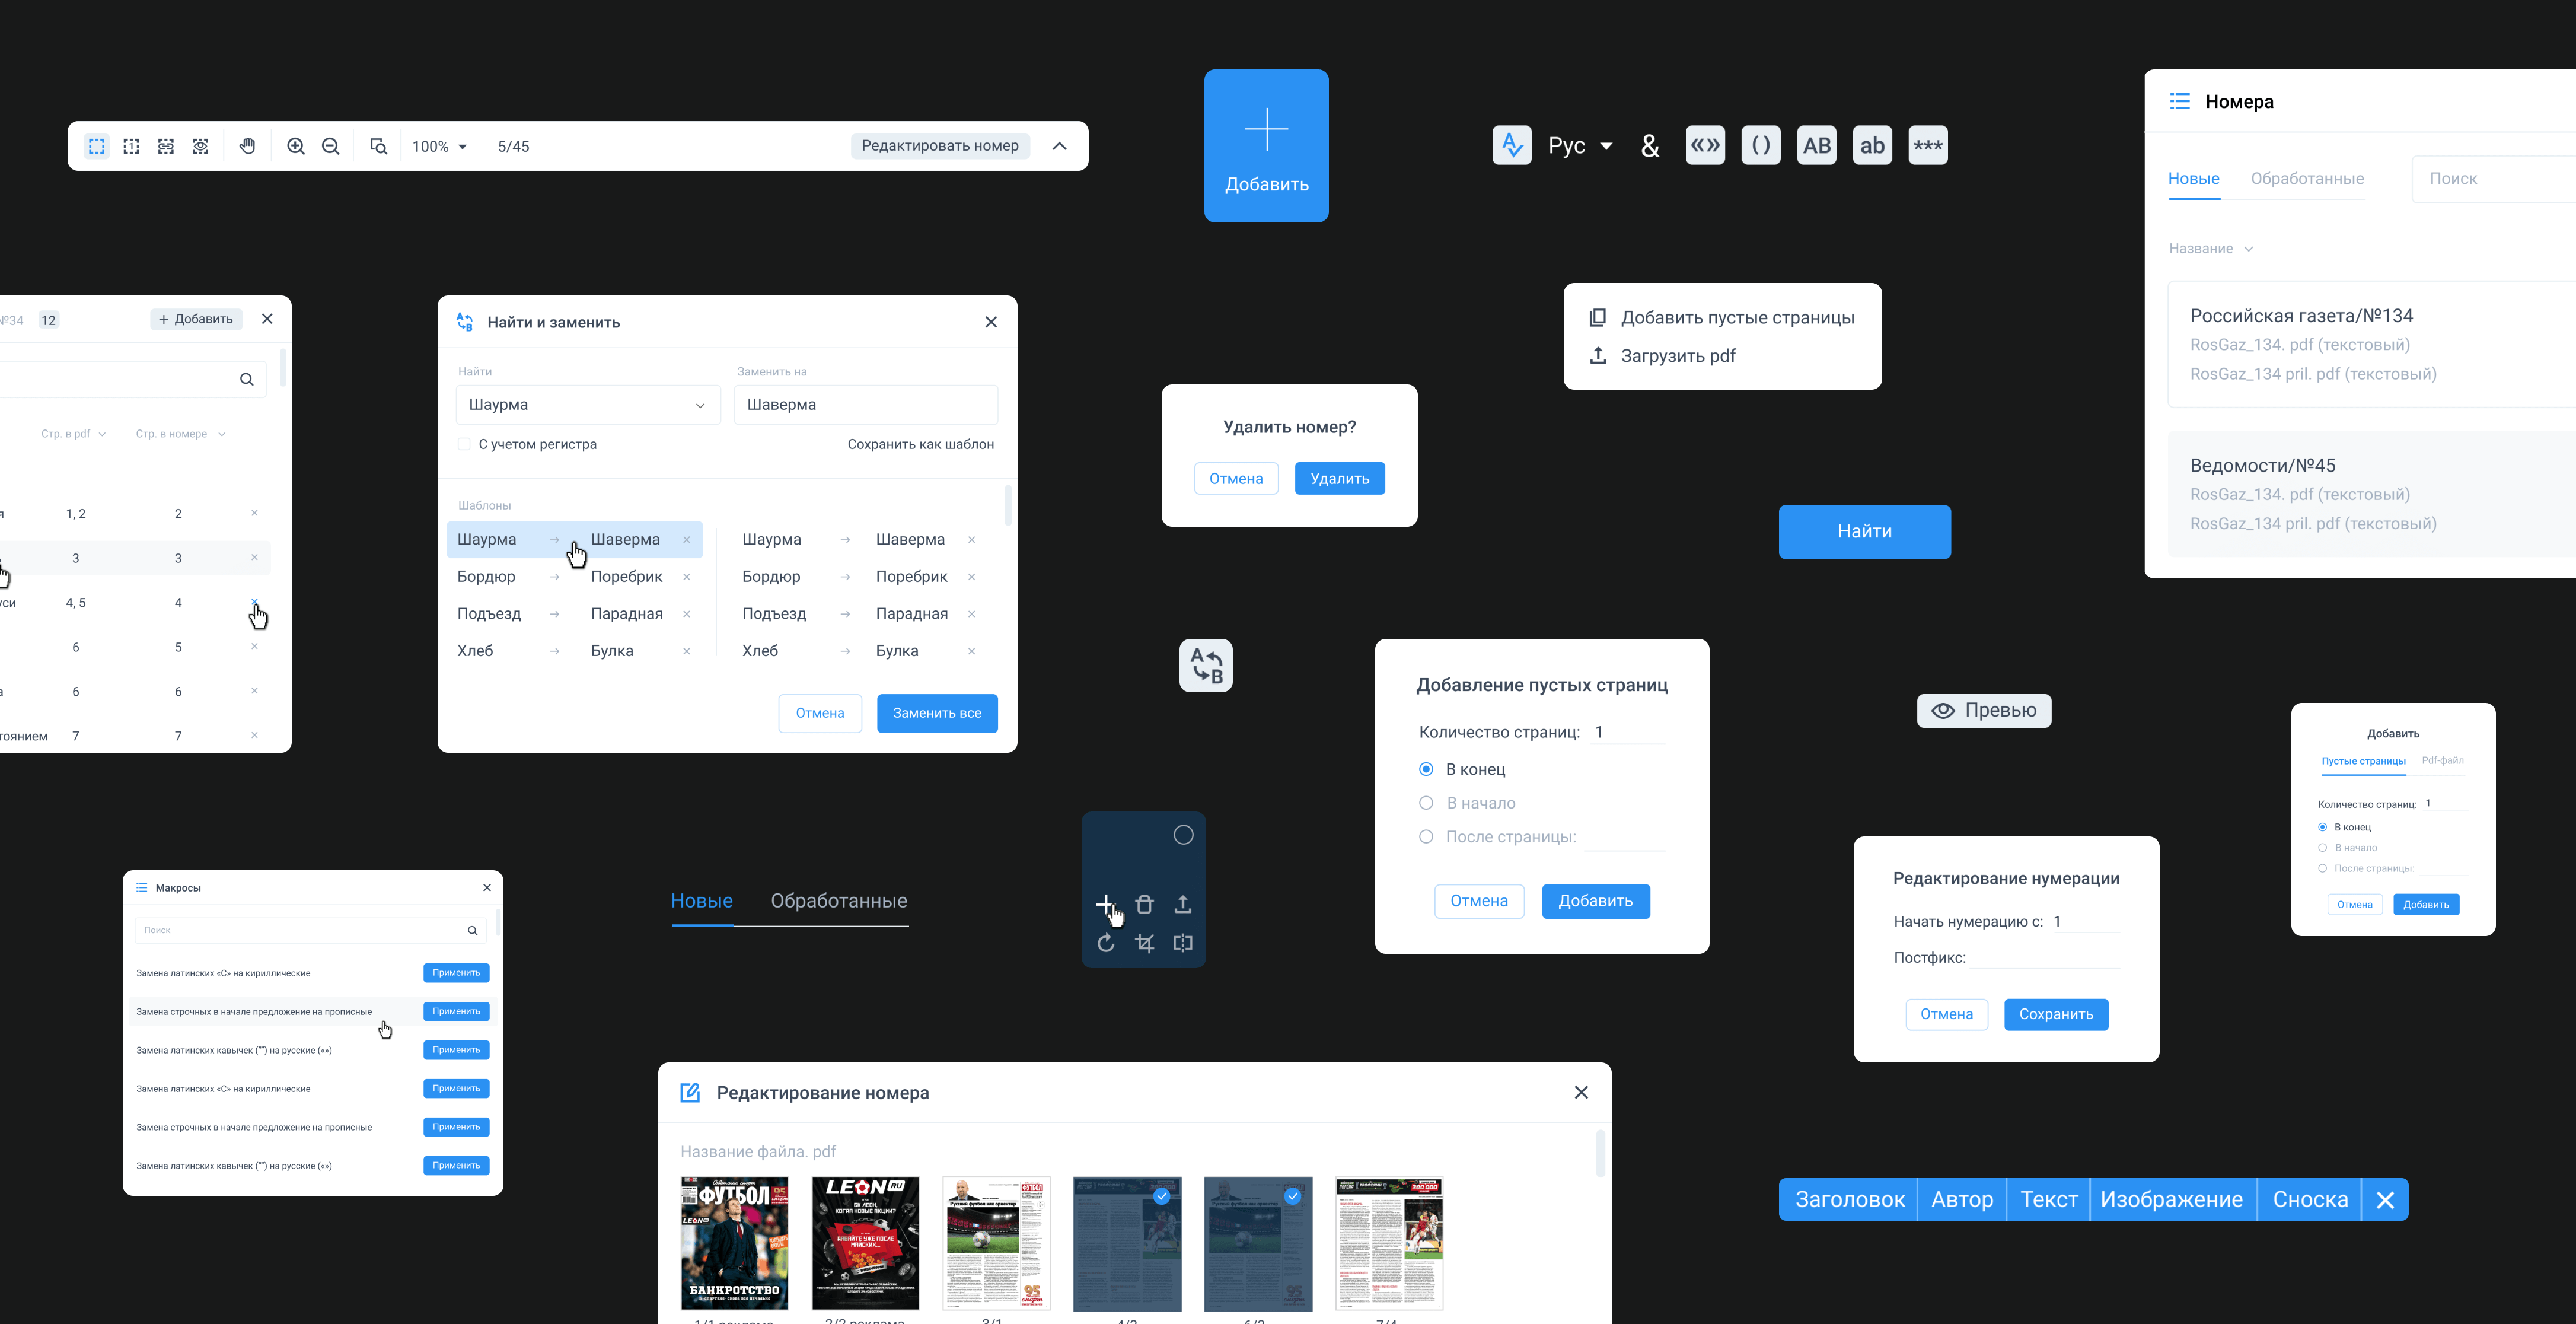
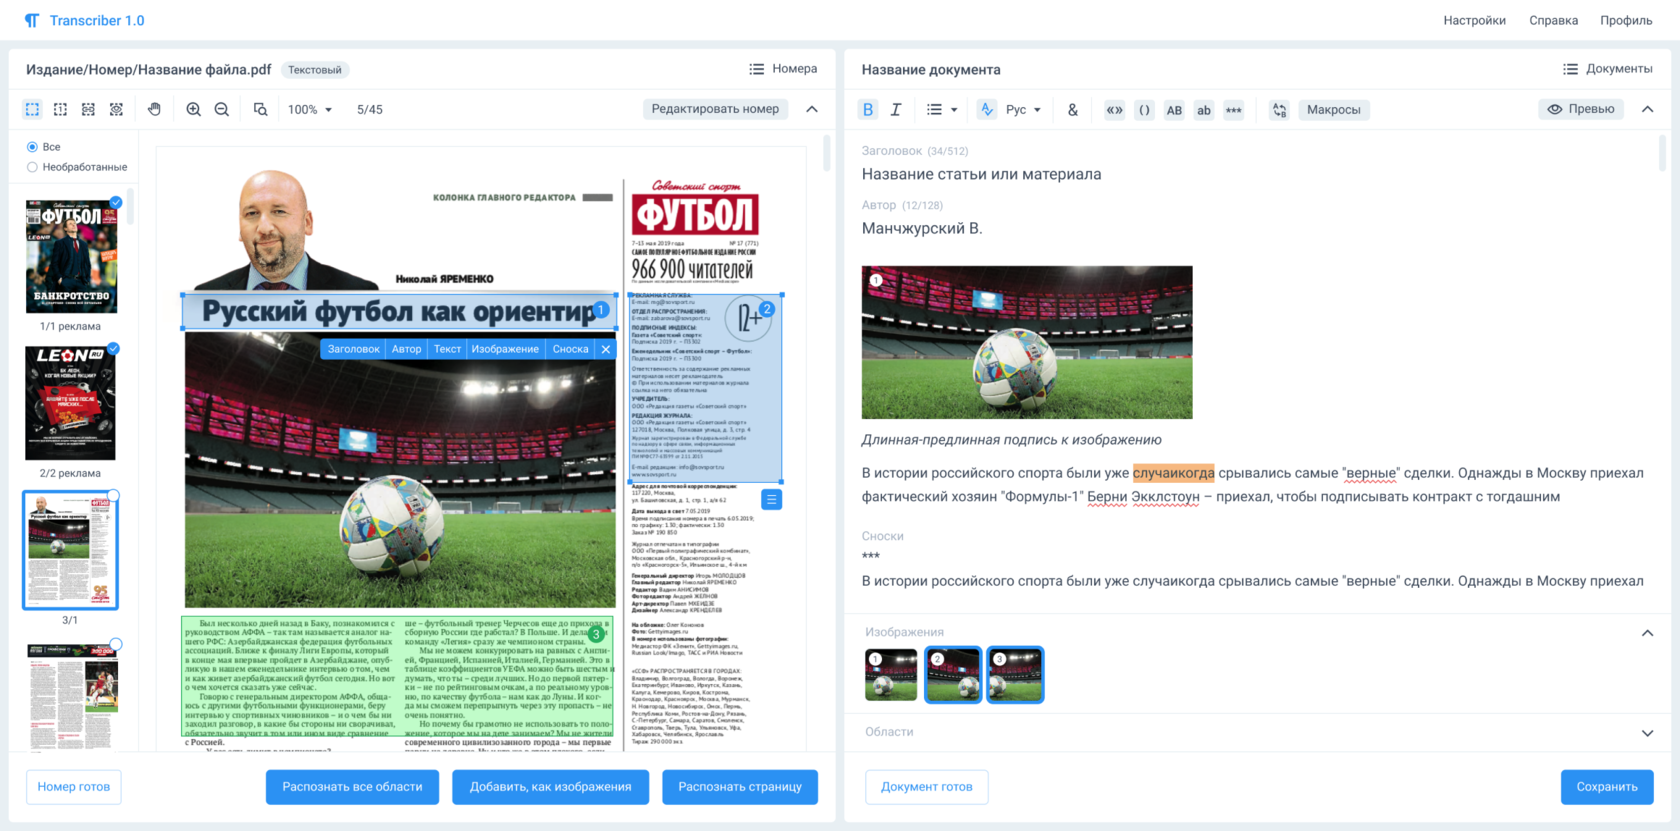
технологии
На чём сделали
- OCR Tesseract
- PostgreSQL
- Django
- GraphQL
- React
- TypeScript
- DraftJS
- Figma
ещё кейсы
Другие проекты
Нужен похожий проект?
Расскажите о задаче: разберём её и предложим решение. Бесплатно.
Алексей СырчинГенеральный директор
